
 4 минуты
«У меня бригада кладёт фундамент быстрее, чем конкуренты успевают смету составить. Но когда спрашиваю Алису «где найти надёжную строительную компанию», она называет кого-то другого», — пожаловался Самсон Ярдов, листая историю запросов в голосовом помощнике на телефоне. Сайт компании «Строим крутые дома» в Google на первой странице. В Яндексе — тоже неплохо. А вот когда клиенты начали спрашивать не поисковик, а нейросеть — его компания там просто не существовала. Как будто все построенные дома внезапно снесли, хотя на деле бизнес работает лучше, чем когда-либо.
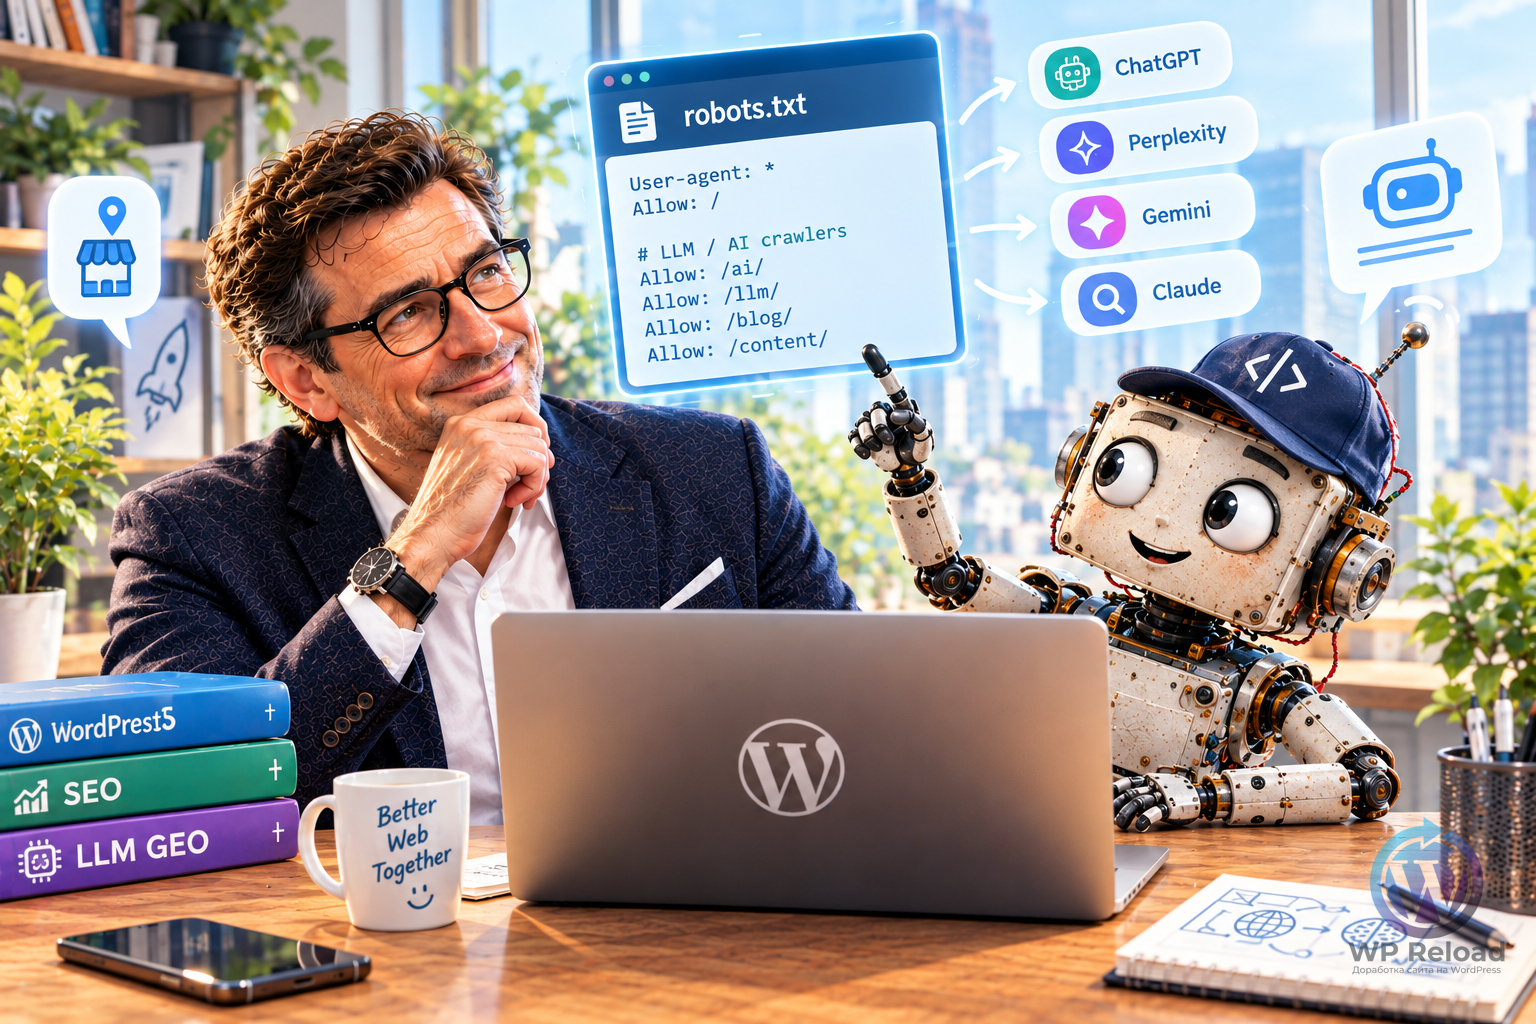
Самсон в своей манере не стал тратить время на панику — сразу спросил технического специалиста: «Что мешает нейросетям нас видеть?» Ответ оказался до смешного простым: файл robots.txt, который годами исправно обслуживал Google и Яндекс, про генеративный ИИ попросту ничего не знал. Представляем готовый robots.txt, адаптированный под популярные LLM — чтобы ваш сайт начал появляться не только в поисковой выдаче, но и в ответах Алисы, ChatGPT, Perplexity и других ИИ-помощников.
robots.txt не только для Google
Классический robots.txt на WordPress-сайте годами решал одну задачу: объяснить Googlebot и Yandex, куда им можно заходить, а куда — не стоит (админка, логин, служебные URL с параметрами поиска — в общем, всё, что не предназначено для чужих глаз). Но пока вы были заняты настройкой для классических поисковиков, на арену вышел новый тип краулеров — боты генеративного ИИ. У каждого из них своё имя, своя задача и своё отношение к вашему сайту: кто-то собирает контент для обучения модели, кто-то — для живого поиска и цитирования в ответах, а кто-то заходит на страницу только в момент, когда реальный пользователь задал ИИ конкретный вопрос.
Если этих ботов не упомянуть явно, большинство из них всё равно будет ориентироваться на общие правила для User-agent: *. Но явное описание — это не просто вежливость, а способ управлять точечно: кому доверяем контент для обучения, а кого пускаем только в режиме поиска и цитирования.
Из чего состоит рабочий robots.txt
Прежде чем разбирать конкретных ботов, вспомним директивы, которые реально используются в файле:
User-agent— для какого именно бота заданы следующие правила. Каждый блок начинается с этой строкиDisallow— какие пути закрыты от обхода. В нашем случае это стандартный набор мусора WordPress: админка, логин, фид, трекбэки, поиск по сайту, параметры комментариевAllow— явное разрешение, даже внутри в целом ограниченной зоны. У нас разрешены файлы изображений, стилей и скриптов из/wp-content/uploads/, чтобы роботы видели оформление и медиаClean-param— директива, специфичная для Яндекса: говорит роботу игнорировать параметры вродеutm_sourceилиgclidпри индексации, чтобы одна и та же страница с разными метками рекламных кампаний не плодила дубли в индексеSitemap— указание, где лежит карта сайта, чтобы робот быстрее находил все страницы, а не блуждал по ссылкам наугад
Боты генеративного ИИ
Вот тут начинается самое интересное. Разбираем, кто заходит на сайт от имени каждой крупной LLM и зачем:
| Бот | Компания | Назначение |
|---|---|---|
| GPTBot | OpenAI | Сбор контента для обучения моделей GPT |
| OAI-SearchBot | OpenAI | Поиск и цитирование в ответах ChatGPT — именно этот бот определяет, попадёте ли вы в выдачу при поиске через ChatGPT |
| ChatGPT-User | OpenAI | Заходит на страницу в реальном времени, когда конкретный пользователь попросил ChatGPT открыть именно эту ссылку |
| ClaudeBot | Anthropic | Сбор контента для обучения моделей Claude |
| Claude-SearchBot | Anthropic | Поиск и индексация для ответов Claude с актуальной информацией |
| Claude-User | Anthropic | Визит по запросу конкретного пользователя внутри диалога с Claude |
| xAI-SearchBot | xAI | Поиск и цитирование для ответов Grok |
| GrokBot | xAI | Сбор контента для обучения моделей Grok |
| YandexAdditional | Яндекс | Обслуживает дополнительные сервисы Яндекса, включая данные, которые использует YandexGPT и Алиса при формировании ответов |
| PerplexityBot | Perplexity | Индексация страниц для ответов и цитирования в Perplexity |
| Perplexity-User | Perplexity | Визит по запросу пользователя внутри Perplexity |
Логика простая: боты с пометкой «поиск» и «пользователь» — это ваш прямой канал попадания в живые ответы нейросетей прямо сейчас. Боты для обучения работают на перспективу — определяют, будет ли модель вообще знать о вашем сайте в принципе, когда в следующий раз её будут дообучать.
Отдельный набор директив под каждого бота
Логичный вопрос: если правила для всех ботов одинаковые — закрыть служебный мусор WordPress, открыть всё остальное — зачем вообще дублировать один и тот же набор Disallow для десятка разных User-agent, а не написать один блок под * и на этом успокоиться?
Ответ в том, что боты не обязаны вести себя одинаково — и правила для User-agent: * можно трактовать ботом по-разному, вплоть до игнорирования, если для него нет явного именного блока. Индивидуальный набор директив под каждого бота даёт три практических преимущества:
- Точечный контроль. Сегодня правила одинаковые для всех — а завтра вы захотите закрыть, например, GPTBot (обучение модели) и при этом оставить открытым OAI-SearchBot (живой поиск и цитирование). С раздельными блоками это правка одной строки, а не археологические раскопки в общем своде правил
- Предсказуемость поведения. Некоторые боты в принципе лучше реагируют на блок, адресованный именно им, чем на общий
User-agent: *— так надёжнее гарантировать, что инструкция действительно применится - Готовность к будущим правкам. Строительная аналогия Самсону особенно близка: заранее заложенные отдельные секции в фундаменте — это как разводка коммуникаций под каждую комнату ещё на этапе стройки, а не штробление стен постфактум, когда дом уже заселён
Карту сайта однократно
Ещё один момент, который легко упустить, копируя шаблон из интернета: директива Sitemap — глобальная для всего файла robots.txt, она не привязана к конкретному User-agent. Это значит, что указывать её отдельно после правил для Yandex, затем ещё раз после правил для Googlebot, а затем ещё раз после каждого ИИ-бота — не нужно. Любой краулер, уважающий robots.txt, прочитает её независимо от того, в каком месте файла она находится, достаточно указать один раз.
Правильная практика — вынести все строки Sitemap в самый конец файла, одним блоком:
Sitemap: https://вашсайт.ру/post-sitemap.xml
Sitemap: https://вашсайт.ру/category-sitemap.xml
Sitemap: https://вашсайт.ру/sitemap_index.xml
Это не только чище с точки зрения структуры файла, но и избавляет от риска забыть обновить ссылку на карту сайта в одном из десяти повторяющихся блоков, если домен или структура sitemap когда-нибудь поменяются.
Готовый robots.txt для ИИ
Вот как выглядит файл, который держит открытыми двери и для классических поисковиков, и для ботов генеративного ИИ — закрывая при этом только служебный мусор WordPress, который в принципе никому не нужен:
User-agent: *
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

Allow: /wp-content/uploads/
Allow: *.css
Allow: *.js
Allow: *.png
Allow: *.jpg
Allow: *.gif
Allow: *.svg

User-agent: Yandex
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

Allow: /wp-content/uploads/
Allow: *.css
Allow: *.js
Allow: *.png
Allow: *.jpg
Allow: *.gif
Allow: *.svg

Clean-param: utm_source&utm_medium&utm_campaign&utm_term&utm_content&gclid&yclid&fbclid&openstat&from&cm_id&utm_referrer&etext&block&source

User-agent: Googlebot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

Allow: /wp-content/uploads/
Allow: *.css
Allow: *.js
Allow: *.png
Allow: *.jpg
Allow: *.gif
Allow: *.svg

# Anthropic
User-agent: ClaudeBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: Claude-SearchBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: Claude-User
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

# OpenAI / ChatGPT
User-agent: GPTBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: OAI-SearchBot
Allow: /
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: ChatGPT-User
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

# xAI / Grok
User-agent: xAI-SearchBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: GrokBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

# YandexGPT
User-agent: YandexAdditional
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: PerplexityBot
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

User-agent: Perplexity-User
Disallow: /wp-admin/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /wp-includes/
Disallow: /xmlrpc.php
Disallow: /readme.html
Disallow: /pinterest-c7e73.html
Disallow: /yapl207244320.html
Disallow: */trackback/
Disallow: */feed/
Disallow: */comments/
Disallow: *?replytocom=
Disallow: /wp-json/
Disallow: /*?s=
Disallow: /*?attachment_id=

Sitemap: https://вашсайт.ру/post-sitemap.xml
Sitemap: https://вашсайт.ру/category-sitemap.xml
Sitemap: https://вашсайт.ру/sitemap_index.xml
Обратите внимание: ни для одного ИИ-бота здесь нет общего Disallow: /. Закрыт только служебный мусор WordPress — тот же набор, что закрыт и от Googlebot. Это сознательная стратегия на видимость: мы хотим, чтобы нейросети видели контент сайта и цитировали его в ответах, а не прятали сайт от генеративного поиска из опасений, которых у экспертного контента быть не должно.
Как обновить robots.txt через FileZilla
Файл лежит в корне сайта, и обновить его можно за пять минут даже без доступа к панели управления хостингом — достаточно FTP-клиента.
- Откройте FileZilla и подключитесь к серверу. Введите хост, логин, пароль и порт в строке быстрого подключения (данные для подключения обычно выдаёт хостинг или панель управления сервером)
- Перейдите в корневую папку сайта. Обычно это
public_htmlили папка с именем вашего домена — именно там рядом сwp-config.phpдолжен лежать файлrobots.txt - Сделайте резервную копию текущего файла. Скачайте существующий
robots.txtк себе на компьютер и сохраните отдельно — на случай, если что-то пойдёт не так - Подготовьте новый файл. Скопируйте готовый текст robots.txt выше в текстовый редактор, замените
вашсайт.руна реальный домен и сохраните файл с именемrobots.txt - Загрузите файл на сервер. Перетащите подготовленный файл из панели локальных файлов FileZilla (слева) в корневую папку сайта на сервере (справа) — система предложит заменить существующий файл, соглашайтесь
- Проверьте результат в браузере. Откройте
https://вашсайт.ру/robots.txtи убедитесь, что видите именно обновлённое содержимое, а не старую версию из кеша
Через пару недель Самсон снова спросил голосового помощника, какая строительная компания в его регионе строит крутые дома — и на этот раз в числе прочих прозвучало и название «Строим крутые дома». «Вот теперь фундамент заложен правильно», — констатировал он тоном человека, который лично принял не один объект под ключ. Если у вас пока нет времени разбираться с ботами, директивами и FTP-клиентами самостоятельно — направьте задачу в свободной форме в dev-team Форсаж, обновим robots.txt под генеративный поиск без лишних вопросов.
Дата публикации: 05.10.2026
Дата обновления: 08.11.2026